※本稿は2026年9月30日時点の公開情報をもとにしています。JevとOpenAI Decisions APIは、私はまだ実際には使っていません。提供状況や仕様は変わる可能性があるため、公開直前にも公式情報を再確認します。
最近「Jev」というAIが話題になっている
最近、「文章を書かないAI」「スマートなif文」などと紹介されるJevが気になっています。
ただ、最初に聞いたときの私の感想は、「結局、普通のLLMに選択肢を渡してJSONで答えさせるのと何が違うの?」でした。
ChatGPTなどの生成AIでも、Structured Outputsやfunction callingを使えば、決められた形式のJSONを返させることはできます。分類やルーティングも、今すでにできます。
それでもJevが気になったのは、文章生成ではなく「ソフトウェア内部の小さな判断」そのものを中心に設計している点です。
さらにOpenAIもDecisions APIを発表しました。両者は同じ技術ではありませんが、分類、ルーティング、次の行動の選択といった近い問題領域を狙っています。
個人ではChatGPT、Codex、GitHub、Google Sheets、Buffer、WordPressなどを組み合わせ、ブログ運営の自動化を進めています。
その立場から見ると、生成AIに文章を書かせることより、「この投稿は次へ流してよいか」「このIssueはどの処理へ回すか」といった途中の小さな判断の方が、最後まで自動化するうえでボトルネックになりやすいと感じます。
そこで今回は、Jevが何を変えようとしているのか、OpenAI Decisions APIと何が共通して何が違うのか、そして個人のAI自動化に今すぐ取り入れる価値があるのかを整理します。
先に結論を書くと、私は今すぐ本格導入はしません。ただし、利用できる状態になったらPoC(小規模な実証)はやってみたい、という判断です。
そもそもJevって何?
2026年9月15日、TypeSafe AIはJevを発表しました。TypeSafeはJevを、同社が「System One Model」と呼ぶ新しいモデル群の最初の公開モデルと位置づけています。
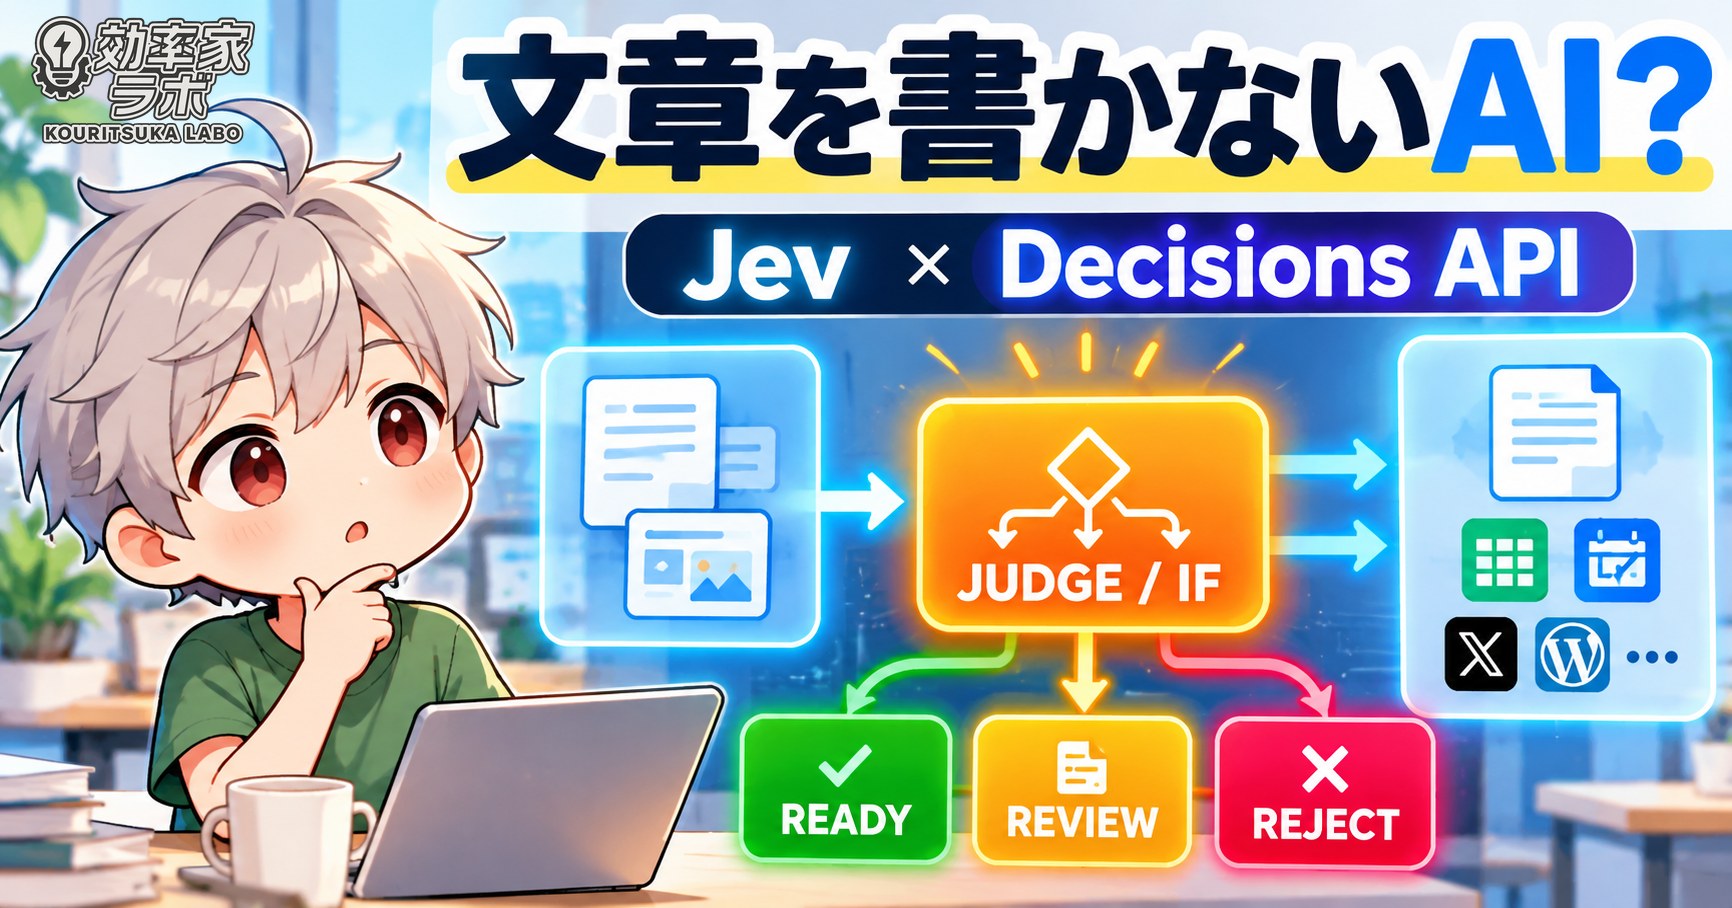
TypeSafeの説明では、普通のLLMが人間向けの文章を生成するのに対し、Jevは「state(判断材料)」と型付きの質問を受け取り、ソフトウェアがそのまま使える構造化された判断を返します。
現在の公開ドキュメントでは、主に3種類の判断があります。
Choice:事前に定義した候補から1つを選ぶ
Score:定義した段階に沿って評価する
Noul:Yes / Noに相当する判断を0〜1の確率で返す
ChoiceとScoreは候補ごとの確率分布とconfidenceも返します。複数の質問を1回のAPI呼び出しに含めることができ、それぞれを同じstateに対して独立・並列に評価する設計です。
TypeSafeは、判断の確率と実際の正答率を近づけるための学習手法として「RLCD(Reinforcement Learning for Calibrated Decisions)」を掲げています。ただし、これはTypeSafe側の技術説明であり、私自身がJevのconfidence精度を検証したわけではありません。
現行ドキュメントではモデルIDは「jev-1.13.0」。APIはPOST /v1/systemoneで、入力はテキスト、JSONオブジェクト、テキスト配列に対応します。一方、画像・音声・動画は現行モデルへ直接入力できず、事前にテキスト等へ変換する必要があります。
Choiceは最大255候補、Scoreは最大10段階です。英語が主な学習言語で精度も最も高く、日本語を含むCJKも扱えるものの、TypeSafe自身が「同等ではないので自分のデータで試すこと」を勧めています。
料金は入力100万トークンあたり0.042ドルで、出力トークンは無料とされています。提供状況はEarly Accessで、発表時点ではwaitlistから順次開放すると説明されています。Early Accessの詳細な参加条件については、公開情報から明確な資格要件までは確認できませんでした。
このあたりまで読むと、「文章を書かないAI」というより、「文章を作る自由度を捨てて、コードの中で使う判断に寄せたAI」と考えた方が分かりやすいです。
「文章を書かないAI」がなぜ必要なのか
普通の生成AIにお願いすると、こんな流れになりがちです。
入力
↓
AIが考える
↓
文章を生成する
↓
「この投稿は公開してもよいと思います」
人間が読むなら、これで十分です。
でも自動化の途中では、文章よりも次のような結果の方が使いやすいことがあります。
入力
↓
決められた候補から判断
↓
READY / REVIEW / REJECT
↓
プログラムが次の処理へ分岐
欲しいのは説明文ではなく、「どのルートへ流すか」です。
もちろん、説明文が必要な場面まで判断AIに置き換える必要はありません。記事を書く、コードを書く、調査結果をまとめる、といった自由度の高い仕事は生成AIの方が向いています。
Jevの公開ドキュメントにも、複雑な推論は1問に詰め込まず、狭い判断へ分解してコード側で組み合わせる考え方が示されています。数学や厳密な数値計算、日付比較もモデルへ任せず、コードで処理することが推奨されています。
つまりJevは「何でもできるAI」を目指すより、AIに任せる判断と普通のコードに任せる処理の境界をはっきりさせる思想に見えます。
普通のLLMにJSONで答えさせればよくない?
ここが一番大事な反論です。
実際、普通のLLMでもできます。ここは先に認めておいた方がよいと思います。OpenAIのAPIにはStructured Outputsがあり、JSON Schemaに沿った構造化出力を返させられます。function callingを使って、候補に応じて処理を分岐させることもできます。JevやDecisions APIがなければ分類やルーティングができない、という話ではありません。
そのため、「Jevが登場したから、これまでのLLMでは分類やルーティングができなくなった」という話ではありません。
むしろ私が導入前に確認したいのは、「普通のLLMでもできることを、専用の判断モデルへ分けるメリットが本当に大きいのか」です。
TypeSafeはJevについて、System One向けの質問では70〜500ms、比較対象によって40〜200倍高速と説明しています。ホームページ上にはさらに大きな速度・コスト差も掲載されていますが、これはTypeSafe自身の評価です。同社も、短い入力がJevに有利な例があること、自社チーム作成のワークフローにはバイアスの可能性があること、最大級の改善値は実運用では高い側の値だと説明しています。
「hallucination zero」のような表現も注意が必要です。TypeSafeが保証しているのは、定義したスキーマ外の型を返さないという意味でのtype safetyです。公式ブログ自身が「0%」は実測値ではなく、schema matchingが保証されるためグラフ上でそう置いていると説明しています。
当然、型が正しくても判断そのものが間違うことはあります。実際、TypeSafeはJev 1.13の弱点として、数値精度、追加の間接推論、文字どおりに解釈しすぎるケースなどを公開しています。
だから私にとっての比較軸は、「JSONが返るか」ではありません。
通常LLM+Structured Outputsで十分安定するなら、APIを増やさない方が運用は簡単です。一方、大量の小さな判断を高速に回し、低遅延・再現性・confidenceまで求める場面で明確な差が出るなら、専用レイヤーを置く意味が出てきます。見るべきなのはAPI単価だけではありません。認証、エラー処理、仕様変更への追従、監視、テストまで含めた運用総コストで、通常LLMより本当に得かを判断する必要があります。
通常のLLM・Jev・OpenAI Decisions APIを整理
| 項目 | 通常のLLM | Jev | OpenAI Decisions API |
|---|---|---|---|
| 主目的 | 文章生成・理解・推論など汎用 | ソフトウェア内部の型付き判断 | 有限候補からのリアルタイム判断 |
| 出力 | 自由文、JSON、Structured Outputsなど | Choice / Score / Noulなど構造化判断 | 事前定義した有限候補からの回答 |
| 自由文章生成 | できる | しない設計 | 主目的ではない |
| 候補の事前定義 | 必須ではない。Schema等で制約可能 | Choice等で定義 | 必須 |
| confidence / probability | 一般的なStructured Outputsの標準機能としては別途設計が必要 | Choice / Scoreは確率分布+confidence、Noulは0〜1確率 | 公開公式仕様では確認できず |
| 速度 | モデル・推論量・出力長次第 | TypeSafeは70〜500ms等を公称。自社評価 | OpenAIは「real-time」と説明。数値仕様は未確認 |
| 料金 | モデル次第 | 入力0.042ドル / 100万token、出力無料 | Decisions API専用料金は未公表・確認できず |
| 提供状況 | 通常APIとして利用可能 | Early Access | limited preview |
| 入力 | モデル次第。Luna等はテキスト・画像対応 | 現行Jev 1.13はテキストのみ | OpenAI公式はテキスト・画像のcontextに対応と説明 |
| 1回で複数判断 | プロンプト/Schema設計次第 | 複数questionを1回に入れられる | 公開公式仕様では確認できず |
| 向く用途 | 文章、要約、推論、柔軟な生成 | 分類、スコア、ルーティング、ガードレール等 | 分類、ルーティング、Agentの次行動 |
| 向かない用途 | 超低遅延の大量小判断では専用方式が有利な可能性 | 自由文生成、厳密な数学・数値処理、複雑な長い推論 | 自由文生成。詳細な制約は公開仕様待ち |
この表を見ると、JevとDecisions APIは似た問題を扱っていますが、同一技術ではありません。
そこへOpenAIも「Decisions API」を発表
のDevDay 2026で、OpenAIはDecisions APIを発表しました。
OpenAI公式の説明では、Lunaの能力を「ユーザーが定義した質問」と「事前に決めた有限個の回答」に集中させ、リアルタイムの判断に使うAPIです。開発者はテキストまたは画像でcontextを渡し、コンテンツ分類、リクエストのルーティング、エージェントが次に取る行動の選択などに使えるとしています。
現時点ではlimited previewで、OpenAIは「coming days」に広く提供する計画だとしています。
ここで大事なのは、「OpenAI版Jev」と雑にまとめすぎないことです。
JevはTypeSafeが独自のSystem One ModelやRLCDを掲げるモデルです。一方、Decisions APIはOpenAIがLunaの能力を有限候補の判断へ集中させるAPIとして発表しています。
狙っている問題領域は近い。しかし、内部技術まで同じと確認できる情報はありません。「OpenAIがJevをコピーした」「Jevに追随した」と断定できる材料もありません。
また、OpenAI公式で私が確認できた公開情報は、用途、Lunaを使うこと、テキスト/画像context、有限候補、limited previewと今後の広範提供までです。
Decisions API専用の料金、正式なAPI endpoint、リクエスト/レスポンスのschema、confidenceやprobabilityを返すか、SDKでどう呼ぶか、1リクエストで複数判断できるかは、公開公式仕様として確認できませんでした。
この状態で非公式サンプルをもとにコードを書くのは早いので、この記事では未確認のままにしておきます。
私なら何に使う?ブログ自動化に当てはめてみた
一番試してみたいのは、すでに動かしているX投稿の仕組みです。
現在は大まかに、
記事
↓
投稿案生成
↓
Google Sheets
↓
人間がREADYを確認
↓
Buffer Draft
↓
最終確認してXへ投稿
という流れにしています。
この流れで、今は私自身がREADYかどうかを判断しています。言い換えると、人間が自動化の途中にある「if文」になっています。ここは今回、判断AIを試す場所としてかなり分かりやすいと感じました。ただし、いきなり「AIが公開可否を決めて自動投稿」にはしません。
まずは投稿案を、
READY:そのまま人間確認へ進めそう
REVIEW:表現・事実・宣伝感などを人が要確認
REJECT:そのまま使わない
の3つへ振り分ける用途から試します。
たとえばconfidenceが十分高いREADYだけ通常の確認レーンへ送り、confidenceが低いものやREVIEW判定は人間へ戻す。これならAIの判断を、人間レビューを減らす補助として使えます。
TypeSafe自身もconfidenceの閾値は用途ごとに自分のデータで決めるよう勧めています。私の用途でも、いきなり「0.8以上なら自動公開」と決めるのではなく、まず正解データを作ってから閾値を決めるべきでしょう。
もう一つはGitHub Issueの振り分けです。
Issue
↓
判断AI
↓
記事制作 / SEO分析 / WordPress作業 / 運用改善 / 人間判断
↓
対応するSkill・Codex・AIへ渡す
この使い方で面白いのは、「AIエージェントをさらに賢くする」ことが主目的ではない点です。
エージェントとエージェントの間にある、「これはどこへ流す?」というif文を少し賢くする。私はJevやDecisions APIの価値を、まずこの「AI版の小さなif文」として見ています。
では、Jevは今すぐ触るべき?
選択肢は3つあります。
1つ目は、今すぐ本格導入する。
私はこれは選びません。JevはまだEarly Accessで、Decisions APIもlimited previewです。仕様や提供条件が動く段階で、本番フローの重要な分岐を依存させるには早いと考えています。
2つ目は、とりあえず触ってPoCする。
私はこれを選びます。ただし「新しいから触る」のではなく、通常LLMから置き換える価値があるかを測るためです。
3つ目は、安定・一般提供まで待つ。
自動化の中に大量の分類やルーティングがなく、今のLLM+Structured Outputsで困っていないなら、これも十分合理的です。
特に個人ブログ程度の処理量では、仮に1回あたりのコストが何十倍違っても、月額差は小さい可能性があります。APIを1つ追加すると、認証、エラー処理、仕様変更への追従、監視、テスト対象が増えます。
「安いから追加する」で運用コストが上がれば、本末転倒です。
日本語の実データで勝てなければ採用しない
PoCを急ぎすぎない理由もあります。
まず、Decisions APIはまだ公開仕様が揃っていません。広範に利用可能になり、endpointや料金、返却形式が見えてからの方が、通常のLuna+Structured Outputsと公平に比較できます。
JevもEarly Accessです。しかも現行ドキュメントでは、英語が最も得意で、日本語を含むCJKは同等ではないと明記されています。
効率家ラボで試すデータは日本語です。TypeSafe自身が英語と同等ではないとしている以上、海外ベンチマークだけでは採用判断できません。ここは注意点というより、私がPoCをやる理由そのものです。
英語ベンチマークで速く安くても、日本語のX投稿候補をREADY / REVIEW / REJECTへ安定して分類できなければ、私の用途では採用理由になりません。
さらに、Jevは数学や厳密な数値、日付比較などをコードで処理するよう推奨しています。つまり「判断AIを入れればif文が全部消える」のではなく、AIに任せる曖昧な判断と、コードで確実に処理するルールを分ける設計が必要です。
私はこの条件になったら実際に試す
開始条件は決めておきます。
第一候補は、OpenAI Decisions APIが私の通常のAPI環境から利用できるようになった時点です。
第二候補は、JevのEarly Accessを取得できた時点です。
どちらか一方が先に使えるようになれば、その時点でPoCを開始します。
両方使えるようになったら、同じデータを同じ分類問題へ通して比較します。
ここを決めておけば、「いつか試したい」で終わりません。
次は「普通のLuna vs Decisions API vs Jev」で比べたい
実機検証では、効率家ラボのX投稿候補など、日本語の実データを20〜50件ほど用意するつもりです。
先に私自身が、
READY
REVIEW
REJECT
の正解ラベルを付けます。
その同じデータを、
人間の正解ラベル
通常のLuna+Structured Outputs
OpenAI Decisions API
Jev
で比較します。
評価するのは、人間判断との一致率、処理速度、料金、実装量、出力の安定性、confidenceの使いやすさ、誤判定したケース、人間レビューへ戻す閾値を作れるか、そしてAPIを1つ追加する運用コストに見合うかです。
可能なら同じ入力を複数回実行し、判断の再現性も確認します。
なお、Decisions APIがconfidenceを返すかは現時点で確認できていません。実際の仕様で返らない場合、その項目はJevだけを評価するか、別の方法で「人間へ戻す基準」を作れるかを見ます。
検証前に採用条件も決めておきます。通常のLuna+Structured Outputsに対して、人間判断との一致率が同等以上で、速度・安定性・confidenceの扱いやすさ・実装運用のいずれかに明確な改善があること。APIを1つ増やす手間を上回る利点が見えなければ採用しません。
最終的に知りたいのは、「どれが一番新しいか」でも「どれがベンチマークで速いか」でもありません。
普通のLLMから置き換える意味が、本当にあったか。
そこまで確認して初めて、私の自動化へ本格導入するかを決めます。
まとめ|「文章を作るAI」だけを見る時代ではなくなるかもしれない
Jevが勝つと決まったわけではありません。
OpenAI Decisions APIが判断AIの標準になるとも、まだ分かりません。
そして、普通のLLMでもStructured Outputsやfunction callingを使えば、分類やルーティングはかなりできます。
それでも今回調べて面白かったのは、「AIに何を生成させるか」ではなく、「ソフトウェアの途中にある小さな判断を、どのモデルへ任せるか」という設計が前面に出てきたことです。
私の今の結論はシンプルです。
本格導入はまだしない。
でも、PoCする価値は十分ある。
使える状態になったら、自分の日本語データで普通のLLMと比べて決める。
新サービスが出るたびにAPIを増やすのは効率化ではありません。
だからこそ、「話題だから触る」ではなく、「置き換える価値があるか測るために触る」。
今回はその順番でいこうと思います。
次回は、OpenAI Decisions APIが通常環境で利用できるようになれば、実際のブログ自動化データを使って検証します。その後、Jevも利用できるようになれば、同じデータで「Jev vs Decisions API vs 普通のLLM」を比較する予定です。
主な確認先
TypeSafe AI「Introducing System One Models & Jev」
TypeSafe AI Docs「Introduction」
TypeSafe AI Docs「API reference」
TypeSafe AI Docs「Jev 1.13 jaggedness」
OpenAI API Docs「Structured model outputs」
ITmedia AI+「『Jev』とは “文章を書かないAI”がなぜ話題に?」
ITmedia NEWS「OpenAIの『DevDay 2026』で発表された主なことまとめ」
※JevおよびOpenAI Decisions APIの仕様・提供状況は変化が速い領域です。本記事では企業の公称値と筆者の判断を分けて記載しています。特にTypeSafeの速度・コスト等の比較値は同社の自社評価であり、筆者自身の実測値ではありません。